某项服务对外只暴露一个 IP(比如 192.168.3.10:8000),所有客户端都访问它。这台机器一宕机,服务就整体不可用——这就是单点故障(Single Point of Failure, SPOF)。
高可用(HA)的经典解法是「主备双机」:部署两台机器(Master 主 + Backup 备)跑同样的服务,正常时只有 Master 对外,Backup 待命;Master 一挂,Backup 自动接管。
但这里有一个问题:客户端只认一个 IP,怎么保证这个 IP 始终可用,而不用关心背后到底哪台机器在扛?
其中一种解法使用浮动 IP(Floating IP),也叫虚拟 IP(Virtual IP, VIP)——一个不属于任何固定机器的 IP,它在主备节点之间「漂移」。
正常时 VIP 绑在 Master 上;Master 宕机后,Backup 把这个 IP 抢过来绑到自己身上;客户端始终访问这个 IP,对背后机器的切换完全无感。
分清三种 IP
一句话区分:动态 IP 是「地址会变,机器不变」;浮动 IP 是「地址不变,背后的机器会变」。
浮动 IP 怎么「漂」起来
要在多台机器间实现 IP 漂移,本质要解决三个问题:怎么绑 IP、怎么让网络知道 IP 换位了、怎么知道什么时候该切换。
机制一:网卡别名(IP Alias)——怎么绑 IP
Linux 允许同一块网卡绑多个 IP,通过「别名」实现:
/sbin/ifconfig eth0:1 192.168.3.198 netmask 255.255.255.0 up   # 绑定
/sbin/ifconfig eth0:1 down                                      # 解绑
eth0:1 就是 eth0 上的一个别名接口,用来承载浮动 IP。IP 漂移的底层动作,本质就是网卡别名的绑定/解绑:
- • Master 成为 active →
ifconfig eth0:1 <VIP> ... up 绑到自己网卡; - • Master 让位 →
ifconfig eth0:1 down 解绑; - • Backup 接替 → 在自己机器上执行同样的
up。
机制二:ARP 与无故 ARP——怎么让网络知道 IP 换位了
ARP(Address Resolution Protocol) 负责把 IP 翻译成 MAC 地址。局域网通信最终靠 MAC,所以每台机器、每台交换机都维护一张 ARP 缓存表(IP ↔ MAC)。
问题来了:VIP 从机器 A 漂到机器 B 后,交换机和其它机器的 ARP 缓存里,VIP 还对应着 A 的 MAC,流量会继续发往 A。
答:无故 ARP(Gratuitous ARP):机器 B 主动广播一条消息「我是 VIP,我的 MAC 是 xx:xx:...」。这条消息不是回答别人的询问(所以叫「无故」),而是主动宣告。之后:
流量于是快速切到 B。这也是 active 节点要周期性地(每 10 秒)发无故 ARP 的原因——持续刷新全网对 VIP 的 MAC 认知。
机制三:心跳与仲裁——怎么知道什么时候切换
有了漂移能力,还得决定「何时切换」,靠三件套:
- 1. 心跳检测:Backup 周期探测 VIP(TCP 连接 echo 端口),连不上就认为 Master 挂了,提升自己为 active。
- 2. 优先级仲裁:多节点同时想当 active(脑裂场景)时,按
priority 决定谁让步。 - 3. 多播广播:节点间用 UDP 多播互相通告「我是 active / 我的优先级」。
Gateway 里是怎么实现的
INFINI Gateway 的浮动 IP = 主备双机高可用,用「网卡别名 + 无故 ARP + TCP 心跳 + UDP 多播 + 优先级仲裁」实现 VIP 漂移。对应 gateway.yml 的 floating_ip 配置块,默认关闭,需 root 权限。
配置长这样
floating_ip:
  enabled:false        # 默认关闭,需 root
netmask:255.255.255.0
ip:''                # 空则自动绑到 x.x.x.234
interface:''         # 空则自动探测网卡
local_ip:''          # 空则自动探测本机 IP
priority:0           # <=0 则随机
echo:
    port:61111
broadcast:
    binding:224.3.2.2:7654   # UDP 多播地址
注意:enabled 默认是 false,而且非 root 用户会被强制禁用(IsRootUser() 不过就直接关掉)。这点很多第一次用的人会卡住——配了半天不生效,多半是没拿 root 跑。
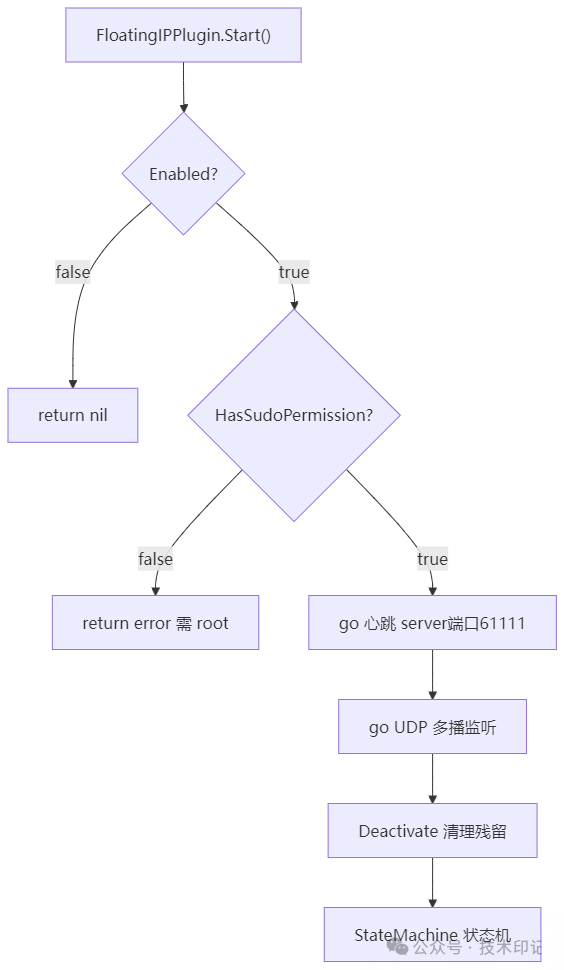
启动流程:先探测,再决定当主还是当备
启动时不是「默认当主」,而是先探测 VIP 有没有人占,再进状态机:
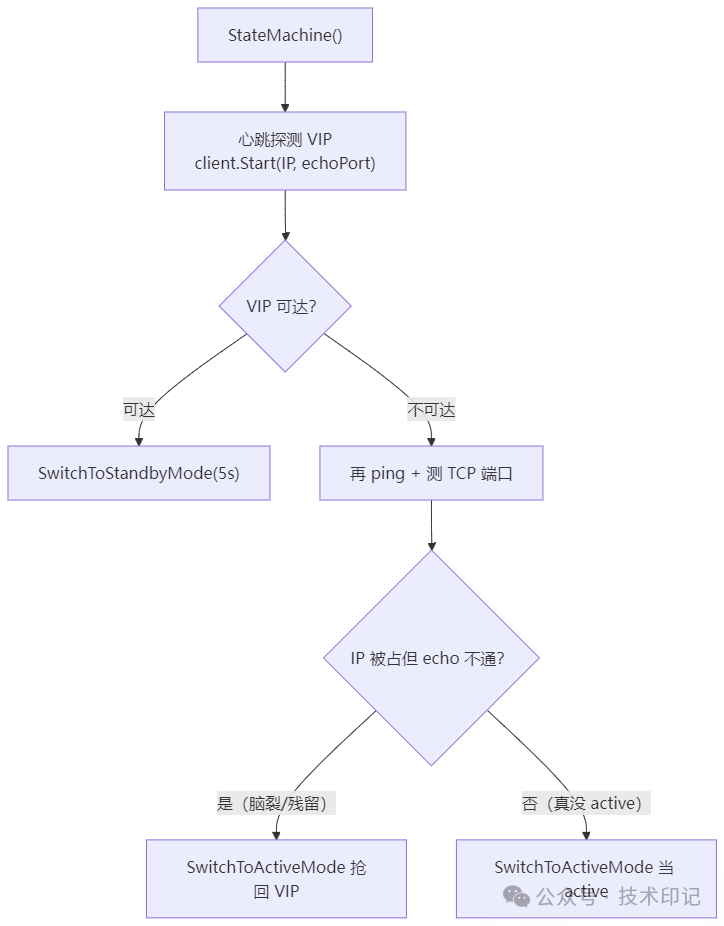
状态机:active / backup 的决策核心
这是整套逻辑的核心——启动时探测 VIP,决定自己当 active 还是 backup:
三个核心切换动作:
| |
| SwitchToActiveMode | 绑 VIP → 每 10s 无故 ARP → 每 10s 多播广播 |
| SwitchToStandbyMode | 解绑 VIP → goroutine 持续心跳探测 active |
| Deactivate | 解绑 VIP → 停掉 arping/broadcast 后台任务 |
SwitchToActiveMode 的核心三动作,代码就三行:
// SwitchToActiveMode 核心三动作
net.SetupAlias(interface, ip, netmask)      // 1. 绑 VIP
task.RunWithinGroup("arping", ...)          // 2. 每10s 无故 ARP
task.RunWithinGroup("broadcast", ...)       // 3. 每10s 多播广播
四个底层组件
① 网卡别名绑定/解绑——直接调系统命令,别名固定叫 infini(即 eth0:infini):
func SetupAlias(device, ip, netmask string) error {
    exec.Command("/sbin/ifconfig", device+":infini", ip, "netmask", netmask)
}
func DisableAlias(device, ip, netmask string) error {
    exec.Command("/sbin/ifconfig", device+":infini", "down")
}
平台差异明显:Linux 用 ifconfig、macOS 用 ifconfig -alias、其它平台直接不支持。
② 无故 ARP 通告——用 github.com/j-keck/arping 发,每 10 秒一次,Windows 等平台不支持:
func announceFloatingIP(ip net.IP, iface string) error {
    return arping.GratuitousArpOverIfaceByName(ip, iface)
}
③ TCP 心跳——active 当 server(监听 61111,每 3 秒 push 心跳包,5 秒读超时判死),backup 当 client 周期性连接,连不上即认为 active 挂了。
④ UDP 多播广播——active 周期广播「我是 active,priority=...」,backup 监听多播做仲裁:
func Broadcast(config, req) {           // 发送:广播「我是 active,priority=...」
    net.DialUDP("udp", nil, "224.3.2.2:7654"); c.Write(json)
}
func ServeMulticastDiscovery(config, h) {  // 接收:监听多播,收到做仲裁
    l, _ := net.ListenMulticastUDP("udp", nil, addr)
    for { l.ReadFromUDP(b); h(src, n, b) }
}
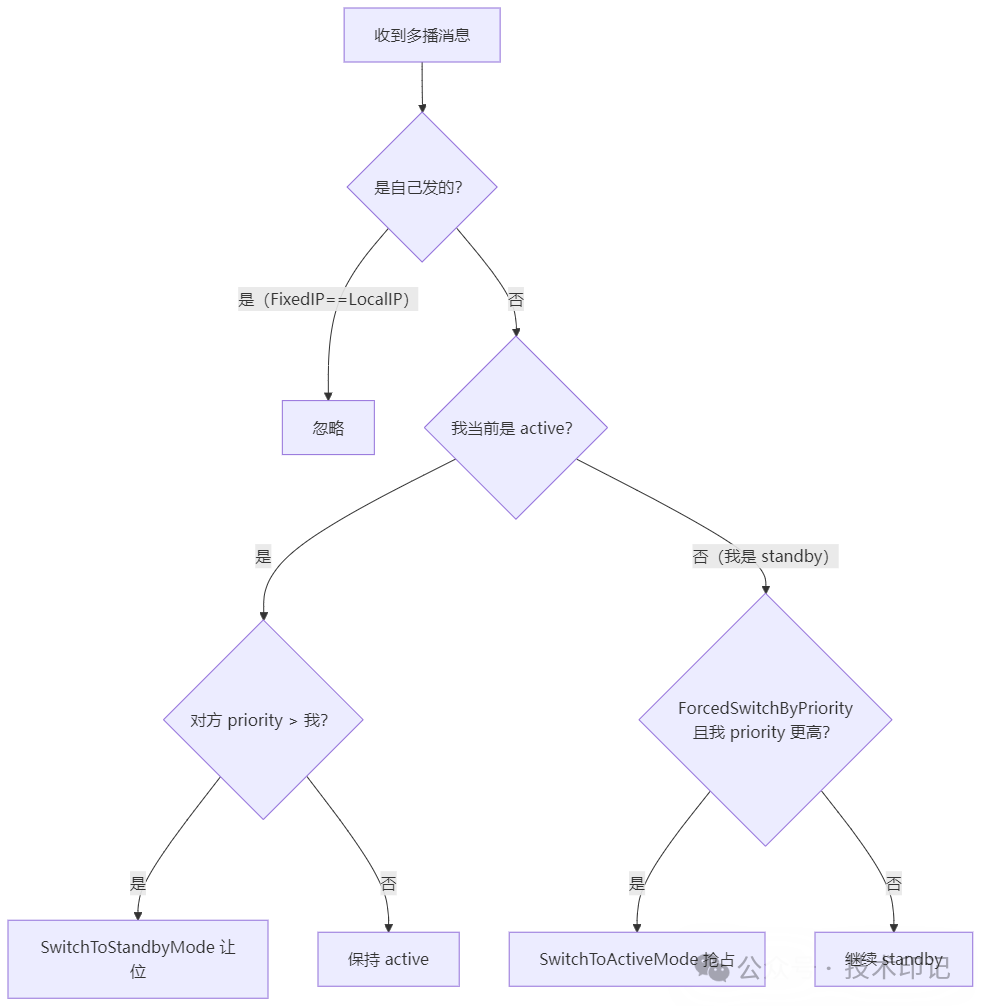
优先级仲裁与脑裂处理
多播收到「别人也自称 active」时的仲裁逻辑:
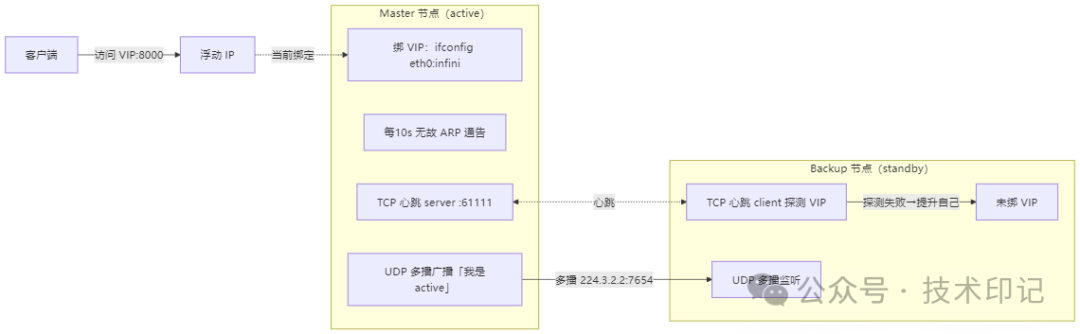
完整架构图:
浮动 IP 存在的问题
浮动 IP 解决单点故障的同时,也引入了一系列新风险。其中最核心的是——脑裂。
脑裂(Split-Brain)
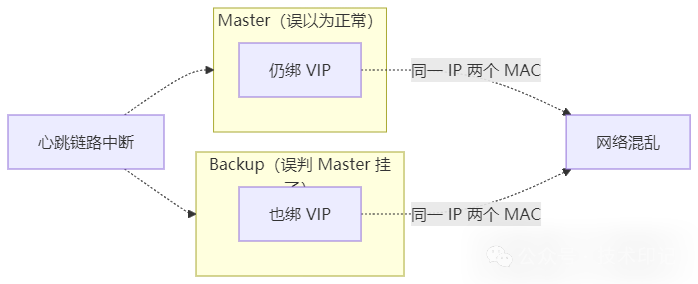
现象:主备节点间心跳链路中断(网络分区、交换机故障、网线松动),但两台机器其实都活着:
- • Backup 探测不到 Master → 误判其挂了 → 提升自己为 active,也绑 VIP;
结果:两台机器同时绑同一个 VIP,客户端请求被随机路由到不同机器,数据写入错乱、状态不一致。
关键点:gateway 用 priority 仲裁 + ForcedSwitchByPriority 让低优先级者让位,但只能缓解、不能根治——彻底网络分区时连多播都互相收不到,仲裁也失效。
root 权限(安全隐患)
绑网卡别名、发无故 ARP 都需 root,HasSudoPermission() 不过就直接报错。后果是:进程以 root 运行,gateway 一旦有漏洞被攻击,攻击者直接拿 root 权限,危害面极大,也违背「最小权限原则」。
依赖系统命令(脆弱)
exec.Command("/sbin/ifconfig", ...) 这条有隐患:ifconfig 正被 ip 命令取代,部分新发行版(新版 Debian/Ubuntu minimal)默认没装 net-tools,/sbin/ifconfig 不存在就直接失败;进程内执行外部命令,也有注入/路径风险。
切换过程其实不是「无感」
- 1. 秒级感知窗口:从「Master 真挂」到「Backup 完成绑 VIP + ARP + 全网刷新」之间,请求会失败或超时(echo timeout 默认 10s,状态机还 sleep 10s)。浮动 IP 是「自动恢复」,不是「零中断」。
- 2. 存量 TCP 连接会断:VIP 漂移只影响新连接路由,已建立的 TCP 长连接(如传输中的 bulk 请求)会直接断——连接是四元组绑定的,漂移救不了存量连接。
- 3. ARP 缓存刷新时间差:无故 ARP 发出去后,不是所有交换机/客户端都立即更新,缓存过期前(几十秒到几分钟),部分流量仍发往旧 Master 的 MAC,造成「部分请求黑洞」。
配置与运维的隐性成本
- • 依赖同二层网络:VIP 靠 ARP 在二层传播,主备必须在同一广播域(同网段/同交换机/同 VLAN),无法跨路由器。跨网段、跨机房、云上(VPC)基本没法用——云平台不让你随意发无故 ARP、绑任意 IP。这也是云上用「弹性 IP(EIP)/负载均衡」而非自绑 VIP 的原因。
- • 参数复杂易配错:
priority <= 0 会随机(rand.Intn(1000)),可能产生意外抢占;自动探测网卡/IP 在复杂网络(多网卡、多网段)下可能探测错。 - • 与容器/编排冲突:K8s、Docker 里容器 IP 是平台管理的,自己
ifconfig 绑 VIP、发 ARP 会和 CNI 插件冲突,通常不可用。
什么时候该用它,什么时候别用



 400 186 1886


